ローカルLLMとは
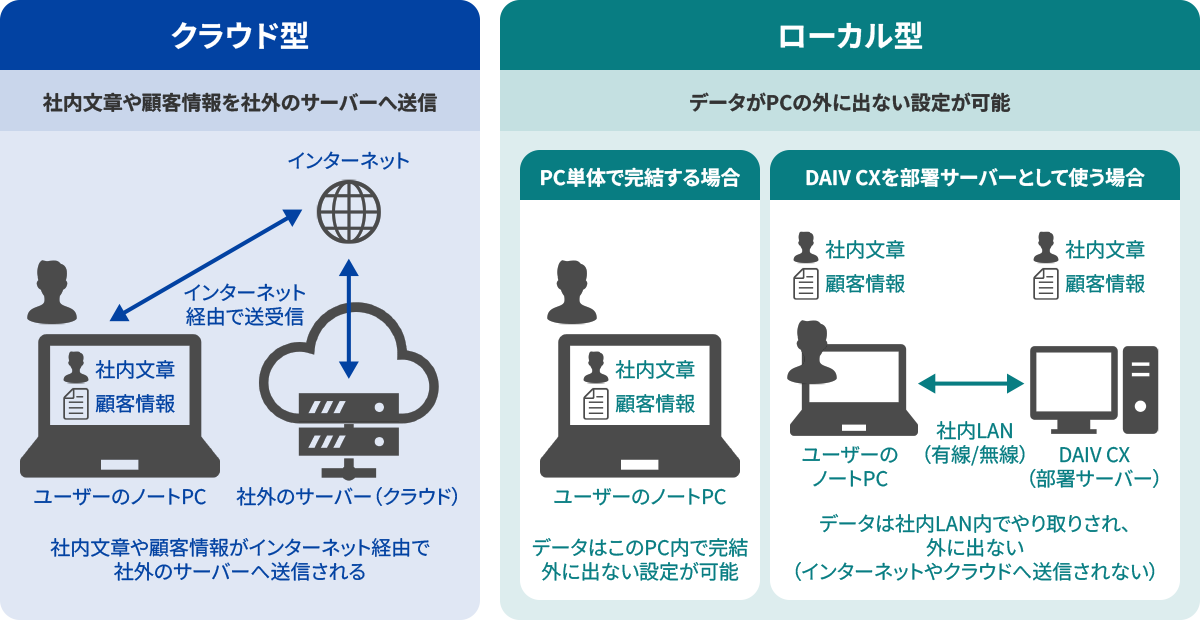
ローカルLLMとは、AIモデルをクラウド上ではなくPC内で実行する仕組みです。
ChatGPTやClaudeなどの生成AIが普及する一方で、
機密情報の取り扱いや利用コスト、インターネット接続への依存を課題として感じるケースもあります。
ローカルLLMは、こうした課題への選択肢として注目されています。
近年はgpt-ossやQwen、Gemmaなどのオープンモデルが進化し、1台のPCでも実用的なAI活用が可能になってきました。
ローカルLLM 運用メリット
-
① 機密情報を守れる
顧客情報、契約書、設計データ、人事資料など、業務で本当にAIに任せたい文書ほど、セキュリティ規定でクラウドに送れないというジレンマがあります。ローカルLLMはデータが一切PCの外に出ないため、 この種の文書を最初からAI処理の対象にできます。
-
② 定額・追加コストなしによる「無制限の運用環境」の実現
使えば使うほど従量課金やサブスク費用が積み上がるクラウドと違い、初期投資の後はどれだけ生成しても電気代を除いて基本的に追加費用がかかりません。確認のための再実行や別モデルでの検算も、料金や回数制限を気にせず好きなだけ行なえます。
-
③ 大規模モデルを手元で
128GBのユニファイドメモリによって、24GBや48GBのVRAMでは動かせない80GB級の大型モデルまで選択肢に入ります。クラウド級に近い品質のモデルを手元で動かすという使い方の受け皿になれるのは、大容 量ユニファイドメモリ機ならではです。
-
④ Windowsでそのまま運用
OSやアプリの操作に新しく覚えることがほとんどなく、インストールも通常のWindowsソフトと変わりません。Microsoft Intuneをはじめとする既存のデバイス管理基盤にもそのまま載せられるため、会社の 管理下にあるPCとして運用できます。
文書の要約・事実整理、対話での相談、社内資料を検索・参照して答えるRAGのような使い方の土台に。
ローカルLLM向けPCとは
ローカルLLMを快適に活用するには、利用するAIモデルに応じたPC性能が求められます。
特にGPUやメモリ容量によって、利用できるモデルや処理速度は大きく変わります。
そこで今回は、各構成での検証結果をもとに、ローカルLLMに適したPCをご紹介します。
検証結果
生成AI分野の実践と発信で知られる新 清士氏が、DAIV CXの実力を実機で検証しました。
どの規模のモデルが動き、どんな速度で応答し、実務のどこまで任せられるのかを確認しています。
① 検証サマリー
-
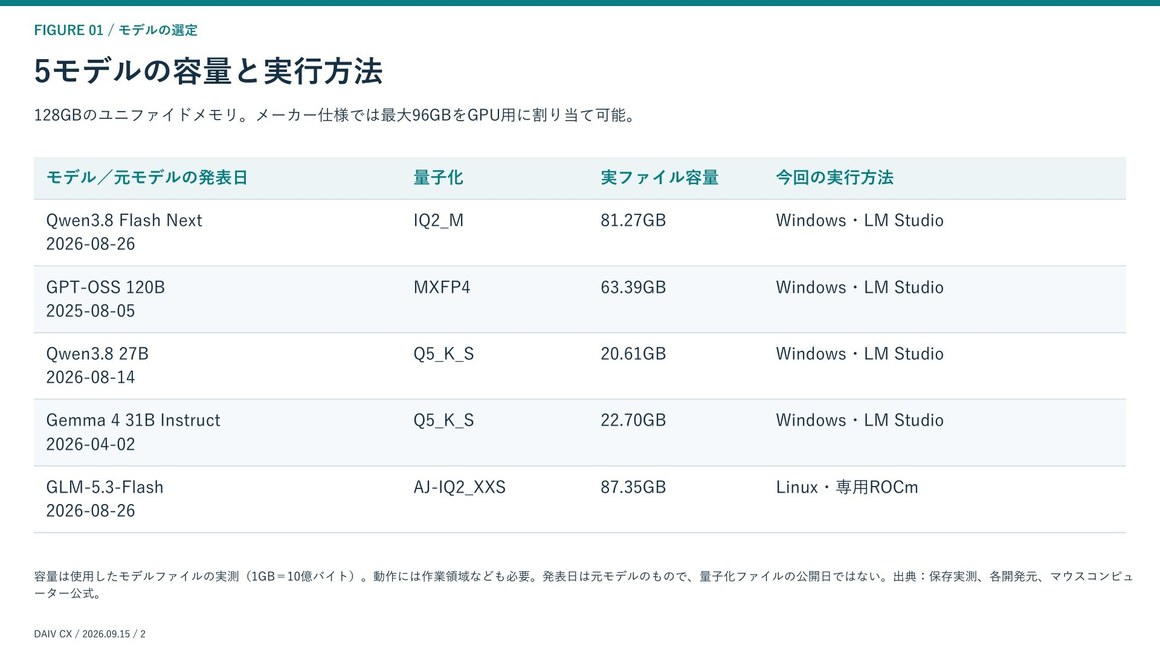
80GB級を含む5モデルを1台のPCに同居させ、切り替えながら検証しました。大型3種はVRAM 24GBや48GBのdGPUでは動作せず、96GBをグラフィックスメモリに割り当てられるDAIV CXだからこそ、この顔ぶれが最初 からすべて候補に残りました。
※ 図版は横にスクロールできます
-
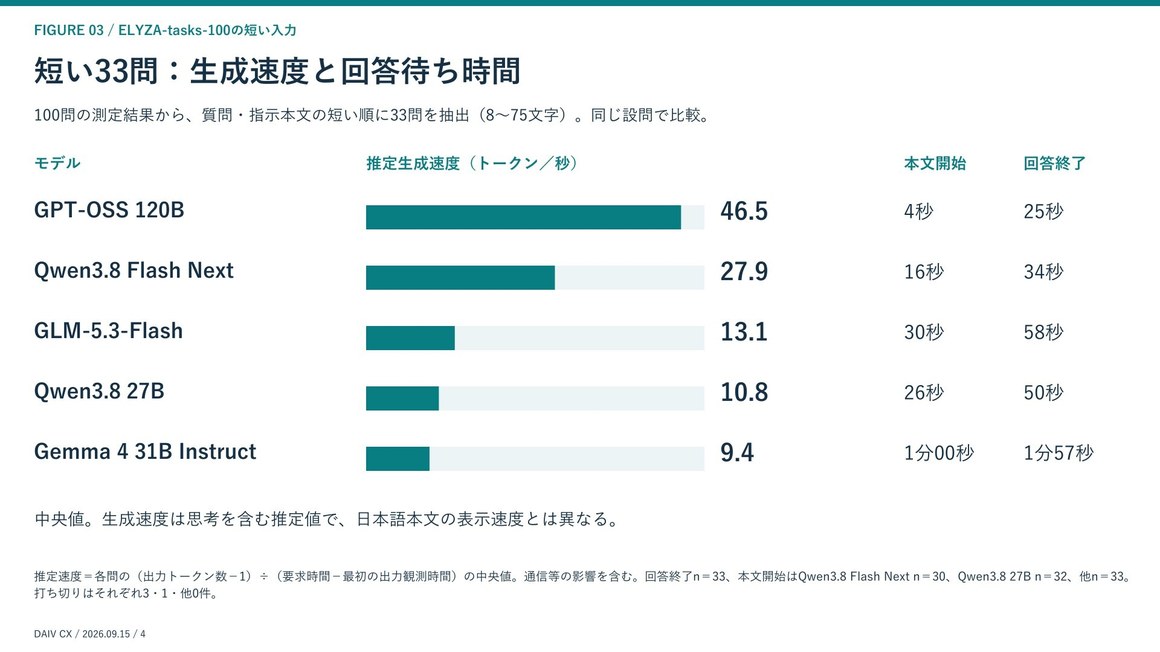
短い33問での推定生成速度の中央値は、gpt-oss-120bが46.5トークン/sec、Qwen3.8-Flash-Nextが27.9トークン/secでした。80GB級の大型モデルであっても、対話的に使える速度が出ています。
※ 図版は横にスクロールできます
-
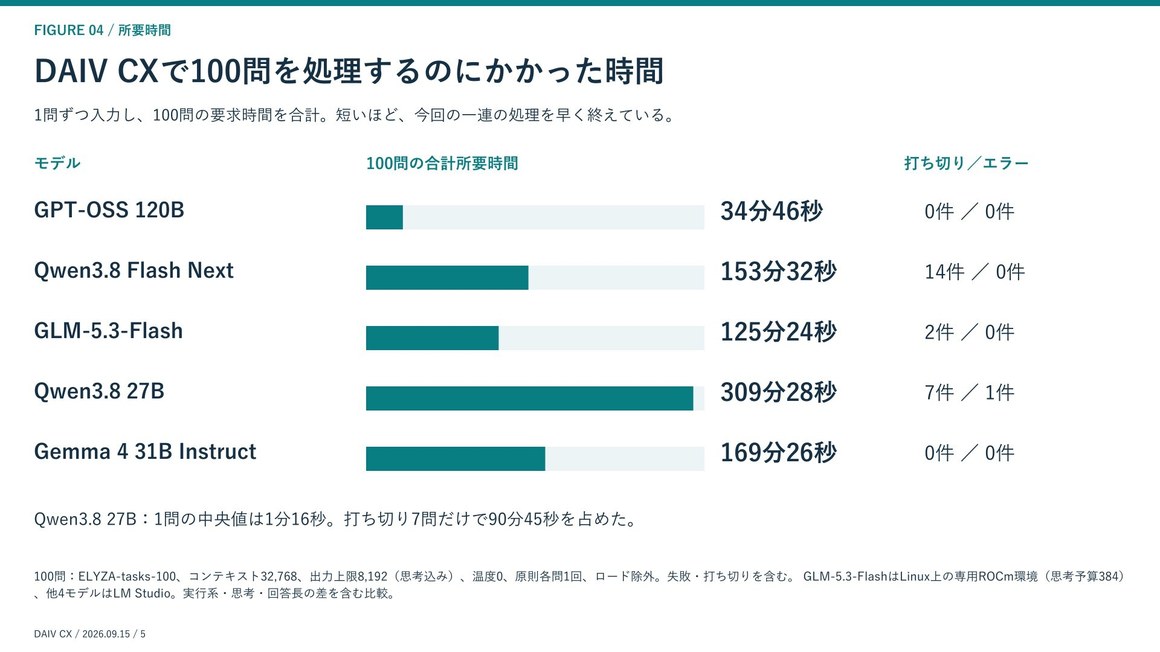
5モデルとも100問を最後まで処理し切りました。数時間に及ぶ連続推論でも動作は安定しており、まとまった量のタスクを流し続ける使い方に耐えることを確認しています。
※ 図版は横にスクロールできます
-
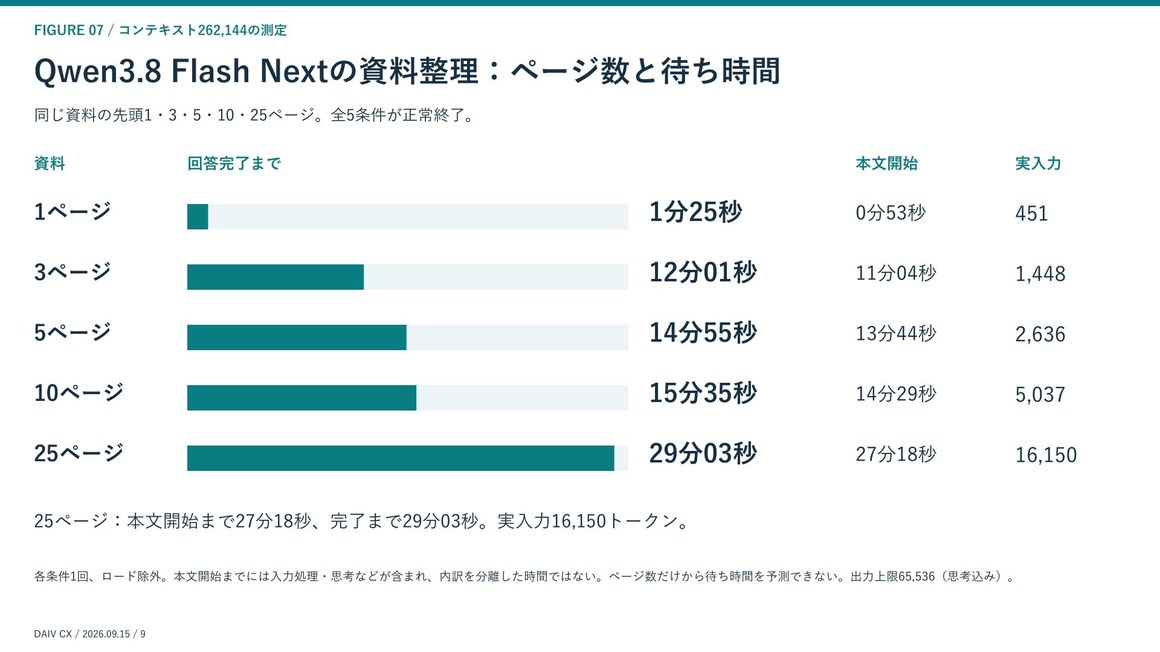
コンテキスト長262,144トークン(400字詰め原稿用紙なら約655~1,311枚、長編小説数冊分)を設定して動作を確認しました。大型モデルを読み込んでなお、書籍数冊分の資料を一度に扱える余白を残しています。
-
25ページの英語資料の要約では、資料内で記載が食い違う原資料側の不整合を検出しました。資料全体を一度に読み込めたからこそ拾えた、横断的なチェックの成果といえます。
※ 図版は横にスクロールできます
② ハードウェア的裏付け
-
Windowsで完結する導入と運用
従来、ローカルLLMの運用というと、Linux環境の構築やコマンドライン操作が前提になりがちでした。DAIV CXなら、LM Studio対応モデルである限り、Windows PCのセットアップと同じ感覚でそこまで到達できます。専用機を別途管理する負担がなく、既存のPC運用の延長線上に置けます。
-
128GBユニファイドメモリ
CPUとGPUが共有する128GBのユニファイドメモリを搭載し、最大96GBをGPU用メモリとして割り当てられます。モデルの大きさとコンテキスト長のどちらかをあきらめるというトレードオフに悩まされないことが、128GBユニファイドメモリの特色です。
-
小型・低消費電力で回し続けやすい
ハイエンドdGPUがピーク時に600W近くを要するのに対し、本製品はモバイル向けに設計されたSoCを核とする小型筐体で、消費電力は圧倒的に小さく抑えられます。処理を数十分実行させる使い方や、サ ーバー化して常時待機させる運用では、電力と発熱の少なさが「回し続けやすさ」につながります。
③ 検証者の視点
大型モデルを動かす価値について
基本的にLLMのパラメータが増えれば増えるほど、出力の品質が向上します。クラウド級により近い品質の大型モデルを手元に置きたいなら、それが動く環境はこの価格帯ではDAIV CXが有力な候補となります。60GBや80GBといったクラスのLLMが動くこと自体が、本製品の価値です。
資料整理・RAGの土台として
ローカル環境なら、確認のための再実行や別モデルでの検算を、利用料や回数制限を気にせず何度でも行なえます。実務でこうした資料整理の対象となるのは、多くの場合そもそも社外に出せない文書でしょう。手元で完結するDAIV CXの環境は、その前提に最初から合致しています。
日常の道具として
動く範囲の広さと、始めるまでの障壁の低さ。この2つを1台で両立していることが、DAIV CXの核となる特徴です。大型ローカルLLMを日常に取り入れたい人にとって、DAIV CXは現実的な答えになります。
新 清士(しん きよし)
1970年生まれ。株式会社バリーン・スタジオ Creative Tech Lab.所属/デジタルハリウッド大学大学院教授。ゲームジャーナリストとして活躍後、VRマルチプレイ剣戟アクションゲーム 「ソード・オブ・ガルガンチュア」の開発を主導。クラフト系サバイバルゲーム「Exelio」のAIによるキャラクターデザイン、3Dプロップを担当。著書に『メタバースビジネス覇権戦争』(NHK出版新書)。AIのエンタメ分野応用に関連する記事を多数執筆。
Windows 11 Pro
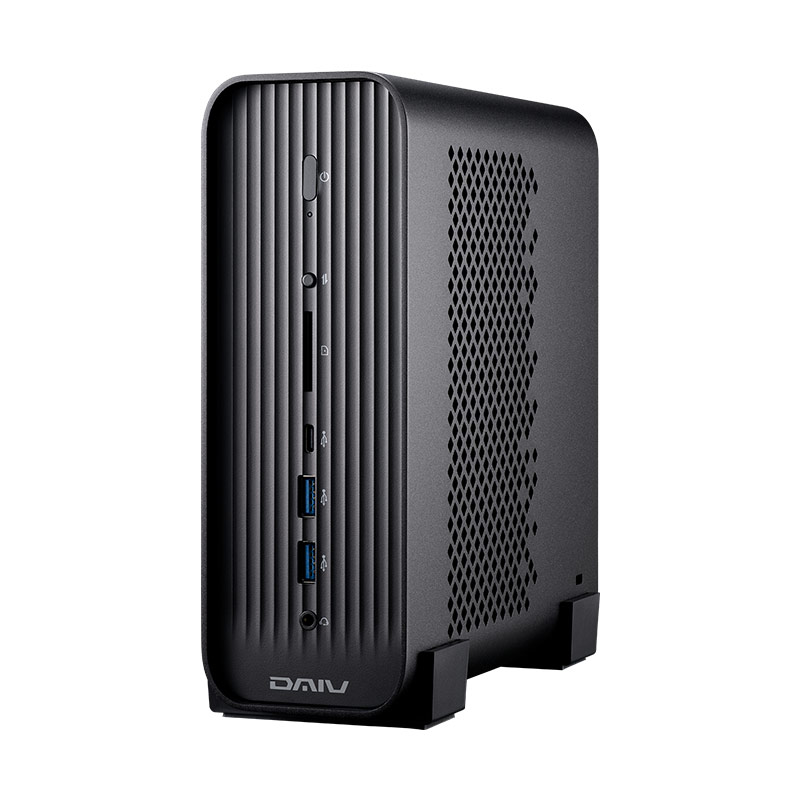
AMD Ryzen AI Max+ 395 プロセッサ搭載モデル。幅78.5mmの縦置きコンパクトデザインのデスクトップPC
- Windows 11 Pro 64ビット
- AMD Ryzen™ AI Max+ 395 プロセッサ
- AMD Radeon™ 8060S グラフィックス
- 128GB (オンボード128GB) ※ビデオメモリと共有のため、割り当て容量を変更することができます。設定により、システムメモリの容量は増減します。
- 2TB (NVMe Gen4×4 / Western Digital WD_BLACK SN850X)
- Wi-Fi 7 ( 最大2.8Gbps ) 対応 IEEE 802.11 be/ax/ac/a/b/g/n準拠 + Bluetooth 5内蔵
- 3年間センドバック修理保証・24時間×365日電話サポート
949,800円~ 税抜863,455円~
導入事例
近日公開!
※ 製品の仕様及び価格は予告なく変更となることがございます。
※ セール、キャンペーン等は予告無く変更または終了する場合がございます。
※ 当ページの掲載内容は、在庫などの都合により予告無く変更または終了となる場合がございます。
※ 画像はイメージです。